Orquestração de Pipelines - Apache Airflow
Esta página documenta como utilizamos o Apache Airflow para orquestração de pipelines de dados no Data Lake Lavoro.
🔄 O que é Apache Airflow?
Apache Airflow é uma plataforma open-source para criar, agendar e monitorar workflows programaticamente.
Principais Características
- DAGs (Directed Acyclic Graphs): Workflows definidos como código Python
- Agendamento: Execuções programadas (cron, intervalos)
- Monitoramento: Interface visual para acompanhar execuções
- Retentativas: Retry automático em caso de falhas
- Dependências: Controle de ordem de execução entre tarefas
- Extensibilidade: Operators e hooks customizados
Por que Airflow?
- ✅ Código como configuração: Versionamento e revisão de código
- ✅ Escalabilidade: Suporta centenas de DAGs simultâneos
- ✅ Observabilidade: Logs detalhados e métricas de execução
- ✅ Comunidade: Grande ecossistema de integrações e plugins
- ✅ Flexibilidade: Python nativo para lógicas complexas
🏗️ Como Utilizamos o Airflow
Componentes do Apache Airflow
Antes de ver a estrutura de um DAG, é importante entender os principais componentes:
| Componente | Descrição |
|---|---|
| DAG (Directed Acyclic Graph) | Grafo direcionado acíclico que representa um workflow completo. Define quais tarefas serão executadas, em que ordem e como lidar com falhas. |
| Operator | Unidade individual de trabalho (tarefa). Exemplos: PythonOperator (executa função Python), BashOperator (executa comando bash), BigQueryOperator (executa queries no BigQuery). |
| Hook | Interface para conectar o Airflow a sistemas externos, abstraindo conexão e autenticação. Exemplos: BigQueryHook, GCSHook, PostgresHook. |
| Task Group | Agrupa tarefas relacionadas visualmente na interface, facilitando a organização de DAGs complexos. |
Estrutura de um DAG
Cada pipeline no Data Lake é definido como um DAG:
from airflow import DAG
from airflow.operators.python import PythonOperator
from datetime import datetime, timedelta

# Configurações padrão
default_args = {
    'owner': 'data-engineering',
    'depends_on_past': False,
    'start_date': datetime(2024, 1, 1),
    'email_on_failure': True,
    'email_on_retry': False,
    'retries': 3,
    'retry_delay': timedelta(minutes=5),
}

# Definição do DAG
with DAG(
    dag_id='cdp_bronze_to_silver',
    default_args=default_args,
    description='Pipeline CDP: Bronze → Silver',
    schedule_interval='0 6 * * *',  # Diariamente às 06:00
    catchup=False,
    tags=['bronze', 'silver']
) as dag:

    # Tasks do pipeline
    extract_task = PythonOperator(
        task_id='extract_from_bronze',
        python_callable=extract_bronze_data
    )

    transform_task = PythonOperator(
        task_id='transform_data',
        python_callable=apply_transformations
    )

    load_task = PythonOperator(
        task_id='load_to_silver',
        python_callable=load_to_silver
    )

    # Definir dependências
    extract_task >> transform_task >> load_task
Task Groups
Utilizamos Task Groups para organizar tarefas relacionadas:
from airflow.utils.task_group import TaskGroup

with TaskGroup('bronze_ingestion', tooltip='Ingestão Bronze') as bronze_group:
    ingest_clientes = PythonOperator(...)
    ingest_vendas = PythonOperator(...)
    ingest_produtos = PythonOperator(...)

with TaskGroup('silver_transformation', tooltip='Transformação Silver') as silver_group:
    transform_clientes = PythonOperator(...)
    transform_vendas = PythonOperator(...)
    transform_produtos = PythonOperator(...)

# Dependência entre grupos
bronze_group >> silver_group
📦 Padrão de Task Groups
O que são Task Groups?
Task Groups são agrupamentos lógicos de tarefas relacionadas dentro de um DAG. Eles organizam visualmente o código e a interface do Airflow, facilitando a manutenção e compreensão de pipelines complexos.
Estrutura Padrão
No Data Lake Lavoro, Task Groups são organizados por camada e sistema fonte:
/dags/task_groups/
├── bronze/                                    # Extração de dados brutos
│   ├── {empresa}_{sistema}_bronze.py
│   └── ...
├── silver/                                    # Transformação e limpeza
│   ├── {empresa}_{sistema}_silver.py
│   └── sql/                                   # Templates SQL
│       ├── {empresa}_{sistema}_{tabela}.sql
│       └── ...
└── gold/                                      # Agregação e modelagem dimensional
    ├── dim_{entidade}_gold.py
    ├── fato_{metrica}_gold.py
    └── sql/                                   # Templates SQL
        ├── dim_{entidade}.sql
        ├── fato_{metrica}.sql
        └── ...
Template de Task Group Bronze
Task Groups Bronze focam em extrair dados brutos dos sistemas fonte e armazenar no BigQuery sem transformações.
# Arquivo: dags/task_groups/bronze/desempar_protheus_bronze.py

from airflow.utils.task_group import TaskGroup
from operators.lake_base import LakeBaseOperator
from config.project_params import BQ_BRONZE, GCS_BUCKET

def create_bronze_task_group():
    """
    Task Group para extração Bronze do Protheus - Desempar

    Extrai tabelas do SQL Server (Protheus) e carrega no BigQuery Bronze
    sem transformações.
    """

    with TaskGroup(
        group_id='desempar_protheus_bronze',
        tooltip='Extração Bronze: Desempar Protheus'
    ) as bronze_group:

        # Task 1: Extrair pedidos de compra
        extract_pedidos = LakeBaseOperator(
            task_id='desempar_protheus_pedidos_de_compra',
            source_system='protheus',
            source_table='SC7010',
            destination_dataset=BQ_BRONZE,
            destination_table='desempar_protheus_pedidos_de_compra',
            extraction_type='full',  # full ou incremental
            gcs_bucket=GCS_BUCKET
        )

        # Task 2: Extrair notas fiscais de entrada
        extract_nfe = LakeBaseOperator(
            task_id='desempar_protheus_notas_fiscais_entrada',
            source_system='protheus',
            source_table='SD1010',
            destination_dataset=BQ_BRONZE,
            destination_table='desempar_protheus_notas_fiscais_entrada',
            extraction_type='full',
            gcs_bucket=GCS_BUCKET
        )

        # Tasks podem executar em paralelo
        [extract_pedidos, extract_nfe]

    return bronze_group
Template de Task Group Silver
Task Groups Silver focam em limpar, validar e normalizar dados Bronze, aplicando transformações SQL.
# Arquivo: dags/task_groups/silver/desempar_protheus_silver.py

from airflow.utils.task_group import TaskGroup
from airflow.providers.google.cloud.operators.bigquery import BigQueryInsertJobOperator
from config.project_params import BQ_BRONZE, BQ_SILVER, BQ_PROJECT

def create_silver_task_group():
    """
    Task Group para transformação Silver do Protheus - Desempar

    Aplica limpeza, normalização e regras de negócio aos dados Bronze.
    """

    with TaskGroup(
        group_id='desempar_protheus_silver',
        tooltip='Transformação Silver: Desempar Protheus'
    ) as silver_group:

        # Task 1: Transformar pedidos
        transform_pedidos = BigQueryInsertJobOperator(
            task_id='desempar_protheus_pedidos',
            configuration={
                'query': {
                    'query': "{% include 'task_groups/silver/sql/protheus_pedidos.sql' %}",
                    'useLegacySql': False,
                    'destinationTable': {
                        'projectId': BQ_PROJECT,
                        'datasetId': BQ_SILVER,
                        'tableId': 'desempar_protheus_pedidos'
                    },
                    'writeDisposition': 'WRITE_TRUNCATE'
                }
            },
            params={
                'bronze_dataset': BQ_BRONZE,
                'bronze_table': 'desempar_protheus_pedidos_de_compra',
                'empresa': 'DESEMPAR',
                'sistema': 'PROTHEUS'
            }
        )

        # Task 2: Transformar notas fiscais
        transform_nfe = BigQueryInsertJobOperator(
            task_id='desempar_protheus_notas_fiscais',
            configuration={
                'query': {
                    'query': "{% include 'task_groups/silver/sql/protheus_notas_fiscais.sql' %}",
                    'useLegacySql': False,
                    'destinationTable': {
                        'projectId': BQ_PROJECT,
                        'datasetId': BQ_SILVER,
                        'tableId': 'desempar_protheus_notas_fiscais'
                    },
                    'writeDisposition': 'WRITE_TRUNCATE'
                }
            },
            params={
                'bronze_dataset': BQ_BRONZE,
                'bronze_table': 'desempar_protheus_notas_fiscais_entrada',
                'empresa': 'DESEMPAR',
                'sistema': 'PROTHEUS'
            }
        )

        # Tasks podem executar em paralelo
        [transform_pedidos, transform_nfe]

    return silver_group
Template de Task Group Gold
Task Groups Gold focam em agregar e modelar dimensionalmente dados Silver, criando fatos e dimensões.
# Arquivo: dags/task_groups/gold/fato_pedidos_de_compra_gold.py

from airflow.utils.task_group import TaskGroup
from airflow.providers.google.cloud.operators.bigquery import BigQueryInsertJobOperator
from config.project_params import BQ_SILVER, BQ_GOLD, BQ_PROJECT

def create_gold_task_group():
    """
    Task Group para criação da tabela Fato de Pedidos de Compra

    Consolida pedidos de múltiplas empresas e sistemas, criando tabela
    dimensional otimizada para análises.
    """

    with TaskGroup(
        group_id='fato_pedidos_de_compra_gold',
        tooltip='Fato Gold: Pedidos de Compra'
    ) as gold_group:

        # Task 1: Criar fato consolidado
        create_fato = BigQueryInsertJobOperator(
            task_id='fato_pedidos_de_compra_consolidado',
            configuration={
                'query': {
                    'query': "{% include 'task_groups/gold/sql/fato_pedidos_de_compra.sql' %}",
                    'useLegacySql': False,
                    'destinationTable': {
                        'projectId': BQ_PROJECT,
                        'datasetId': BQ_GOLD,
                        'tableId': 'fato_pedidos_de_compra'
                    },
                    'writeDisposition': 'WRITE_TRUNCATE',
                    'timePartitioning': {
                        'type': 'DAY',
                        'field': 'data_emissao'
                    }
                }
            },
            params={
                'silver_dataset': BQ_SILVER
            }
        )

        # Task 2: Atualizar tabela histórica (opcional)
        update_historico = BigQueryInsertJobOperator(
            task_id='fato_pedidos_de_compra_historico',
            configuration={
                'query': {
                    'query': """
                        INSERT INTO `{project}.{dataset}.fato_pedidos_de_compra_historico`
                        SELECT *, CURRENT_TIMESTAMP() as snapshot_timestamp
                        FROM `{project}.{dataset}.fato_pedidos_de_compra`
                    """.format(project=BQ_PROJECT, dataset=BQ_GOLD),
                    'useLegacySql': False
                }
            }
        )

        # Dependência: criar fato → atualizar histórico
        create_fato >> update_historico

    return gold_group
Padrão de Dependências entre Task Groups
# Arquivo: dags/desempar_protheus.py

from airflow import DAG
from datetime import datetime, timedelta
from task_groups.bronze.desempar_protheus_bronze import create_bronze_task_group
from task_groups.silver.desempar_protheus_silver import create_silver_task_group

default_args = {
    'owner': 'data-engineering',
    'depends_on_past': False,
    'start_date': datetime(2024, 1, 1),
    'email_on_failure': True,
    'retries': 3,
    'retry_delay': timedelta(minutes=5),
}

with DAG(
    dag_id='desempar_protheus',
    default_args=default_args,
    description='Pipeline Desempar Protheus: Bronze → Silver',
    schedule_interval='0 6 * * *',  # Diariamente às 06:00
    catchup=False,
    tags=['bronze', 'silver', 'desempar', 'protheus']
) as dag:

    # Criar task groups
    bronze_group = create_bronze_task_group()
    silver_group = create_silver_task_group()

    # Definir dependência: Bronze → Silver
    bronze_group >> silver_group
Fluxo de Dados Bronze → Silver → Gold
graph TD
    A[DAG: desempar_protheus] --> B[Task Group: Bronze]
    B --> C[Task: extract_pedidos]
    B --> D[Task: extract_nfe]

    C --> E[Task Group: Silver]
    D --> E
    E --> F[Task: transform_pedidos]
    E --> G[Task: transform_nfe]

    F --> I[Task Group: Gold]
    G --> I
    I --> J[Task: create_fato]
    J --> K[Task: update_historico]

    style B fill:#cd7f32,color:#fff
    style E fill:#c0c0c0
    style I fill:#ffd700
Boas Práticas para Task Groups
1. Nomenclatura Consistente
# ✅ BOM: Segue padrão {empresa}_{sistema}_{camada}
group_id='desempar_protheus_bronze'

# ❌ RUIM: Não segue padrão
group_id='bronze_tasks'
2. Documentação Clara
# ✅ BOM: Docstring explicativa
def create_bronze_task_group():
    """
    Task Group para extração Bronze do Protheus - Desempar

    Extrai tabelas do SQL Server (Protheus) e carrega no BigQuery Bronze.
    """

# ❌ RUIM: Sem documentação
def create_bronze_task_group():
    pass
3. Modularização
# ✅ BOM: Task Group em arquivo separado
from task_groups.bronze.desempar_protheus_bronze import create_bronze_task_group

# ❌ RUIM: Tudo no DAG principal (dificulta manutenção)
with TaskGroup('desempar_protheus_bronze') as bronze_group:
    # 100 linhas de código...
4. Reuso de Templates SQL
# ✅ BOM: Template SQL reutilizável via Jinja
'query': "{% include 'task_groups/silver/sql/protheus_pedidos.sql' %}",
'params': {
    'empresa': 'DESEMPAR',  # Parametrizado
    'sistema': 'PROTHEUS'
}

# ❌ RUIM: Query hardcoded no código Python
'query': 'SELECT * FROM bronze_operacoes.desempar_protheus_pedidos WHERE ...'
5. Paralelismo Inteligente
# ✅ BOM: Tasks independentes executam em paralelo
[extract_pedidos, extract_nfe, extract_fornecedores]

# ❌ RUIM: Encadear desnecessariamente
extract_pedidos >> extract_nfe >> extract_fornecedores
Como Criar um Novo Task Group
Passo 1: Criar arquivo no diretório apropriado
Passo 2: Copiar template e adaptar
# Usar template Bronze/Silver/Gold conforme necessidade
# Ajustar nomes de datasets, tabelas e lógica de extração
Passo 3: Importar no DAG principal
Passo 4: Adicionar ao DAG e definir dependências
bronze_group = create_bronze_task_group()
silver_group = create_silver_task_group()

bronze_group >> silver_group
Custom Operators e Hooks
Criamos operators customizados para tarefas específicas:
# operators/bigquery_operator.py
from airflow.models import BaseOperator

class CustomBigQueryOperator(BaseOperator):
    """Operator customizado para executar queries BigQuery"""

    def __init__(self, sql, destination_table, **kwargs):
        super().__init__(**kwargs)
        self.sql = sql
        self.destination_table = destination_table

    def execute(self, context):
        # Lógica de execução
        bq_client = BigQueryHook().get_client()
        job = bq_client.query(self.sql)
        job.result()
Agendamento de DAGs com Cron
O Airflow utiliza expressões Cron para agendar a execução de DAGs. Cron é um formato padrão para especificar intervalos de tempo de forma programática.
O que é Cron?
Uma expressão Cron é composta por 5 campos que definem quando uma tarefa deve ser executada:
┌───────────── minuto (0 - 59)
│ ┌───────────── hora (0 - 23)
│ │ ┌───────────── dia do mês (1 - 31)
│ │ │ ┌───────────── mês (1 - 12)
│ │ │ │ ┌───────────── dia da semana (0 - 6) (Domingo = 0)
│ │ │ │ │
* * * * *
Exemplos de Agendamento
# Diariamente às 06:00
schedule_interval='0 6 * * *'

# A cada 4 horas
schedule_interval='0 */4 * * *'

# De segunda a sexta às 08:00
schedule_interval='0 8 * * 1-5'

# Todo primeiro dia do mês às 00:00
schedule_interval='0 0 1 * *'

# Três vezes ao dia (06:00, 11:00, 16:00)
schedule_interval='0 6,11,16 * * *'
Exemplos Práticos no Airflow
# DAG executado diariamente às 06:00
dag = DAG(
    dag_id='daily_pipeline',
    schedule_interval='0 6 * * *',  # Cron expression
    ...
)

# DAG executado a cada 30 minutos
dag = DAG(
    dag_id='realtime_pipeline',
    schedule_interval='*/30 * * * *',
    ...
)
☁️ Cloud Composer (Airflow Gerenciado)
O Cloud Composer é o serviço gerenciado de Airflow do Google Cloud Platform. Utilizamos a versão Composer 2.16.1 com Apache Airflow 2.10.3.
Topologia Atual (Produção)
Histórico de consolidação
Anteriormente havia 3 Cloud Composers orquestrando 5 projetos. A topologia foi consolidada em 1 único Composer (Lakehouse) orquestrando os 4 projetos atuais (Lakehouse, CDP, Operações, Pessoas). O projeto Tesouraria foi descontinuado.
graph TB
    subgraph CL["☁️ Composer Lakehouse (único)"]
        direction LR
        L1["Lakehouse"]
        L2["CDP"]
        L3["Operações"]
        L4["Pessoas"]
    end

    GH[GitHub - Push Main] -->|Deploy| CL
    CL -->|Processa| BQ[BigQuery]

    style CL fill:#e8f5e9,stroke:#2e7d32,stroke-width:2px
style BQ fill:#4285f4,color:#fff| Composer | Projetos | Região | Composer | Airflow |
|---|---|---|---|---|
| Composer Lakehouse | Lakehouse, CDP, Operações, Pessoas | us-central1 | 2.16.1 | 2.10.3 |
Arquitetura do Composer
graph TB
    A[GitHub - Push Main] -->|Deploy| B[Cloud Composer]
    B -->|Sincroniza| C[GCS Bucket - DAGs]
    C -->|Carrega| D[Airflow Scheduler]
    D -->|Agenda| E[Airflow Workers]
    E -->|Executa| F[Tasks Python/SQL]
    F -->|Processa| G[BigQuery]
    D -->|Logs| H[Cloud Logging]
    D -->|Métricas| I[Cloud Monitoring]

    style B fill:#4285f4,color:#fff
    style D fill:#34a853,color:#fff
    style E fill:#fbbc04,color:#333
Vantagens do Cloud Composer
- ✅ Gerenciamento: Google cuida da infraestrutura
- ✅ Alta disponibilidade: Schedulers redundantes
- ✅ Autoscaling: Workers sobem/descem conforme demanda
- ✅ Integração GCP: Conexões nativas com BigQuery, Storage, etc.
- ✅ Segurança: IAM integrado e Secret Manager
- ✅ Monitoramento: Logs e métricas nativos
Estrutura de Buckets
Cada Composer possui seu próprio bucket GCS dedicado:
gs://lavoro-composer-{nome}/
├── dags/                    # DAGs carregados automaticamente
│   ├── empresa_sistema.py
│   ├── fato_objeto.py
├── data/                    # Dados temporários
├── logs/                    # Logs de execução
└── plugins/                 # Plugins customizados
Importante: Todo o código dos DAGs fica diretamente dentro da pasta dags/, sem subdivisões por área.
🖥️ Ambientes DEV e QA - Docker + VM
Para os ambientes de DEV e QA, utilizamos Airflow rodando em Docker dentro de uma VM do GCP. A estrutura é idêntica para ambos os ambientes, mudando apenas as credenciais e recursos alocados.
Arquitetura DEV/QA
graph TB
    A[GitHub - Push DEV/QA] -->|GitHub Actions| B[VM Airflow DEV/QA]
    B -->|Docker Compose| C[Airflow Webserver]
    B -->|Docker Compose| D[Airflow Scheduler]
    B -->|Docker Compose| E[Airflow Workers]
    B -->|Docker Compose| F[PostgreSQL]
    D -->|Agenda| E
    E -->|Executa| G[Tasks]
    G -->|Acessa| H[BigQuery DEV/QA]

    style B fill:#ea4335,color:#fff
    style C fill:#34a853,color:#fff
    style D fill:#fbbc04,color:#333
    style E fill:#4285f4,color:#fff
Configuração Docker Compose
# docker-compose.yml (simplificado)
version: '3'
services:

######################################################
# DATABASE SERVICE
######################################################
  postgres:
    image: postgres:11.4-alpine
    restart: always
    container_name: postgres
    env_file: ../../config/variables.env
    logging:
      driver: "json-file"
      options:
          max-file: "5"
          max-size: "10m"
    ports:
      - "5431:5432"
    volumes:
      - ../../db:/var/lib/postgresql/data/pgdata
    environment:
      - PGDATA=/var/lib/postgresql/data/pgdata

  adminer:
    image: wodby/adminer:latest
    restart: always
    container_name: adminer
    env_file: ../../config/variables.env
    logging:
      driver: "json-file"
      options:
          max-file: "5"
          max-size: "10m"
    ports:
      - "7070:9000"
    environment:
      - ADMINER_DEFAULT_DB_DRIVER=psql
      - ADMINER_DEFAULT_DB_HOST=postgres

# ######################################################
# # AIRFLOW
# ######################################################

  airflow:
    build:
      context: ../
      dockerfile: docker/Dockerfile
    restart: always
    env_file: ../../config/variables.env
    depends_on:
      - postgres
    container_name: airflow
    volumes:
      - ../../cert:/home/airflow/gcs/cert
      - ../dags:/home/airflow/gcs/dags
    ports:
      - 8080:8080
    deploy:
      resources:
        limits:
          memory: 12g
Deploy Automático (DEV/QA)
O deploy para DEV e QA é automático via GitHub Actions:
- Push para branch
devouqa→ Dispara workflow - GitHub Actions → Conecta na VM via SSH
- Copia DAGs → Atualiza arquivos na VM
- Reinicia serviços → Docker Compose restart (se necessário)
- Airflow detecta → Recarrega DAGs automaticamente
VMs de DEV e QA
Ambiente DEV:
Nome: vm-airflow-lavoro-projeto-dev
Tipo: n2-standard-2 (2 vCPUs, 8 GB RAM)
Região: us-central1-a
Sistema: Debian 11 Bullseye
Ambiente QA:
Nome: vm-airflow-lavoro-projeto-qa
Tipo: n2-standard-2 (2 vCPUs, 8 GB RAM)
Região: us-central1-a
Sistema: Debian 11 Bullseye
🔍 Monitoramento e Observabilidade
Interface Web do Airflow
A interface do Airflow fornece diversas visualizações para monitorar e gerenciar DAGs:
DAG View - Visão Geral dos DAGs
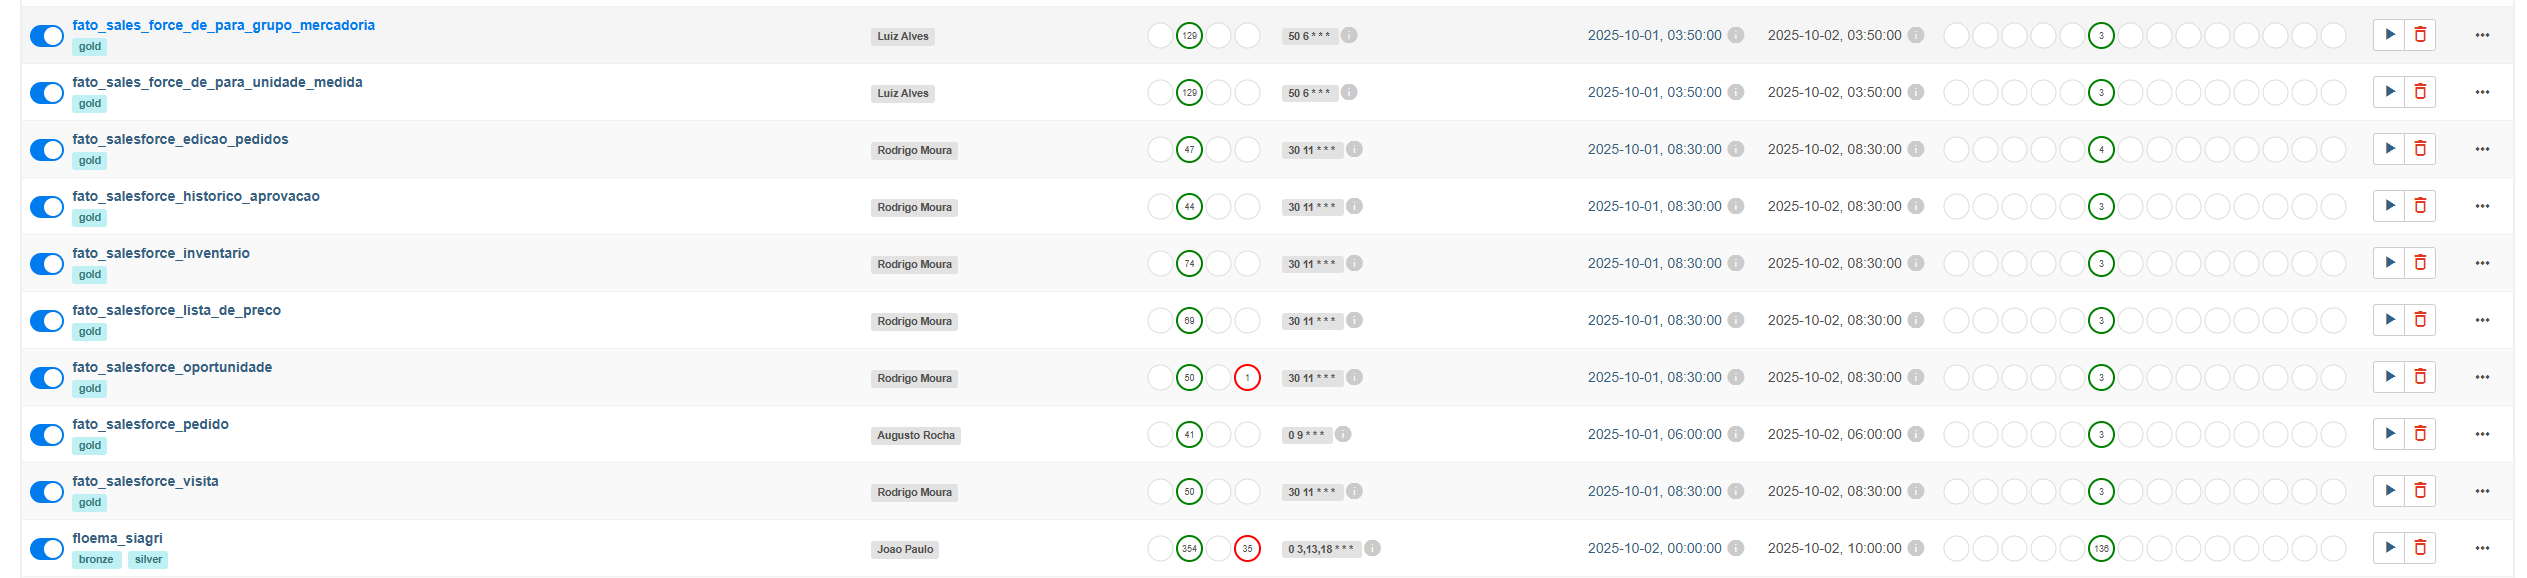 Visualização de todos os DAGs disponíveis no ambiente, com status de execução e informações gerais.
Calendar View - Visão de Calendário
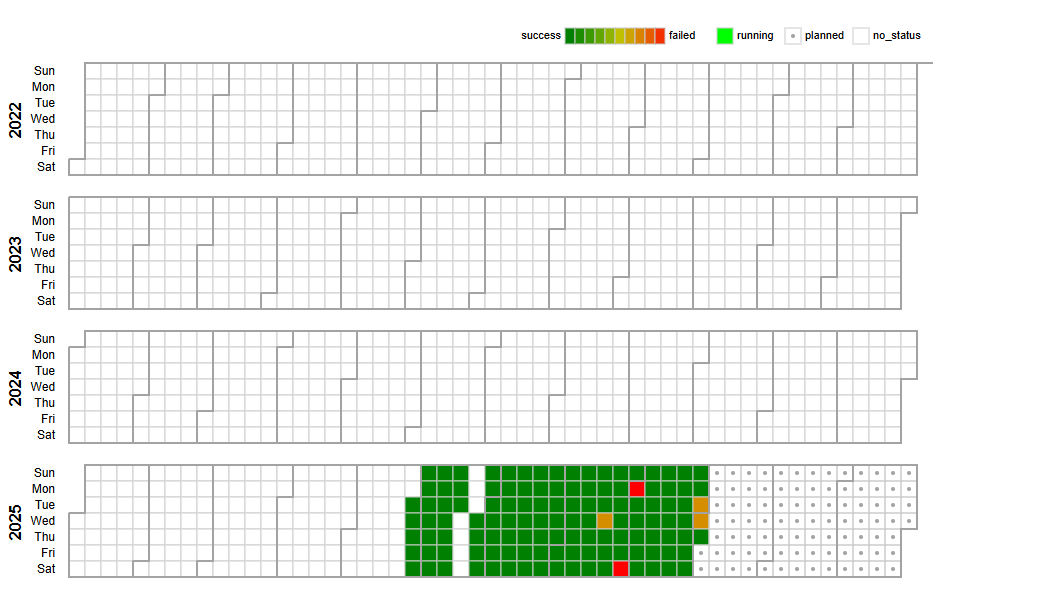 Visualização em calendário mostrando histórico de execuções e seus status ao longo do tempo.
Graph View - Grafo de Dependências
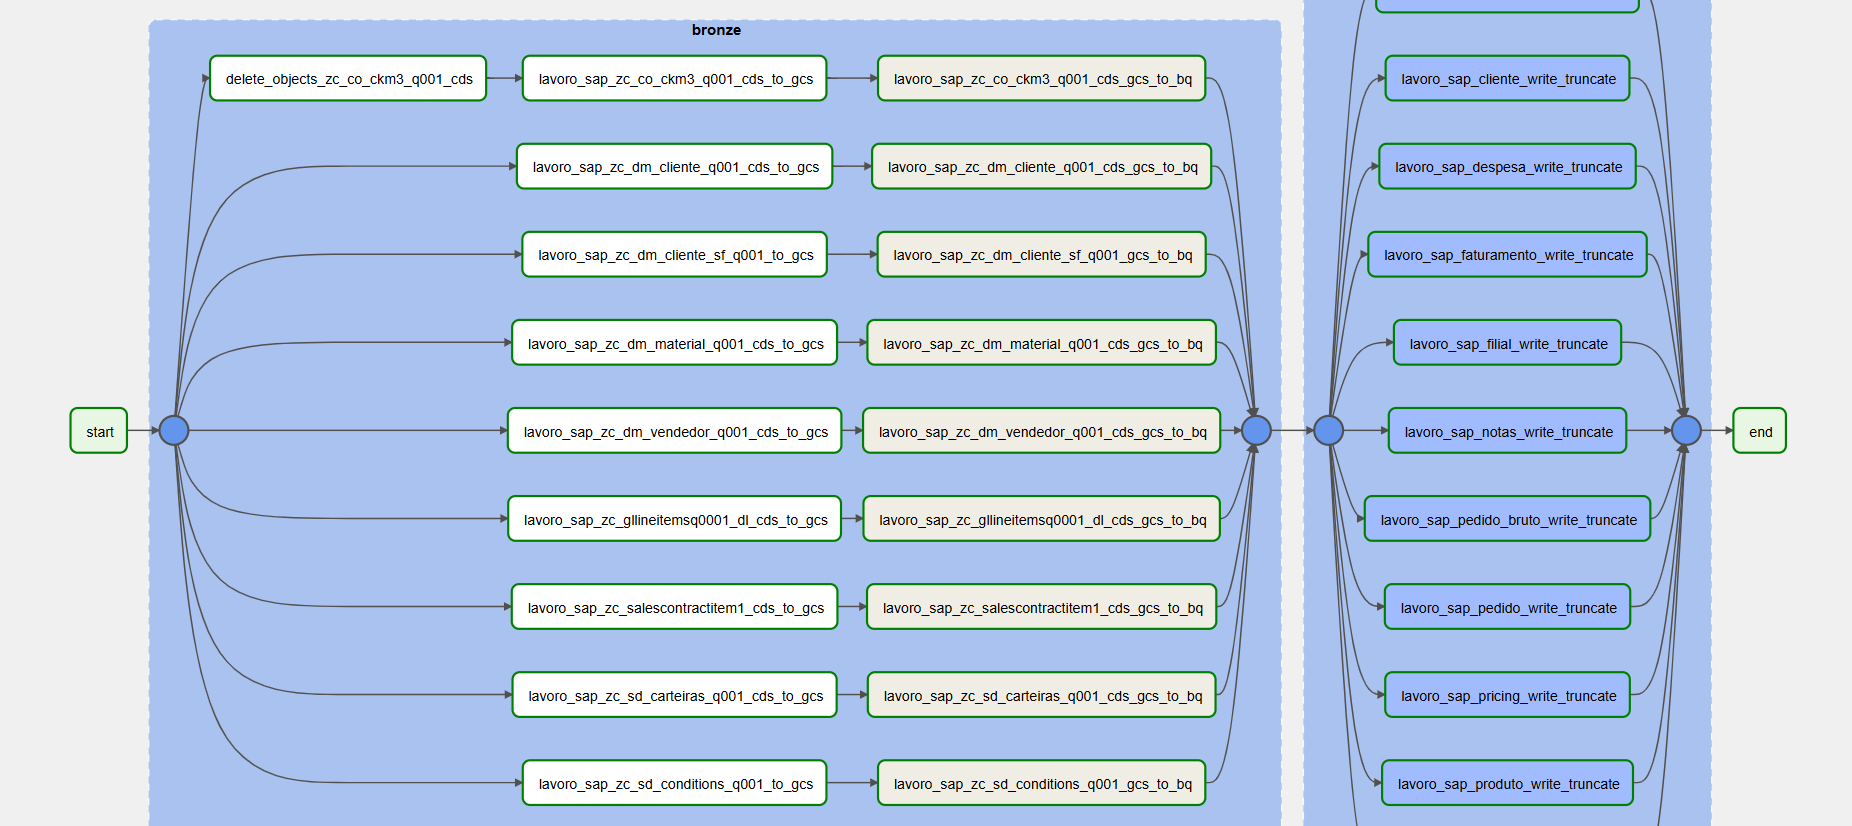 Grafo visual mostrando as dependências entre tasks e o fluxo de execução do DAG.
Grid View - Visão de Grid
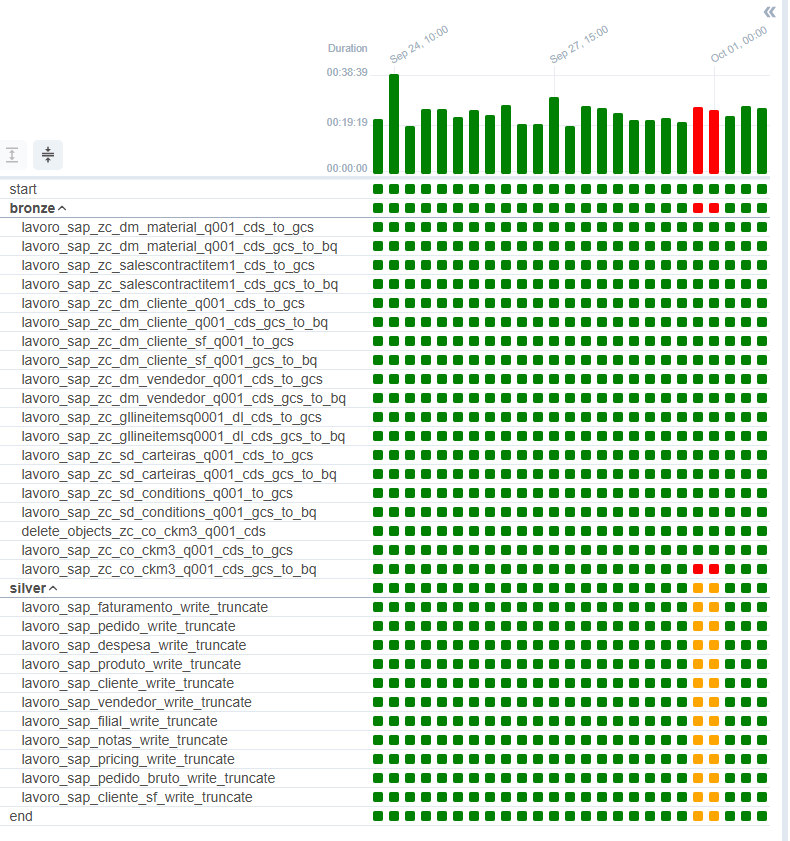 Visão em grid com histórico detalhado de execuções de cada task ao longo do tempo.
Log View - Logs Detalhados
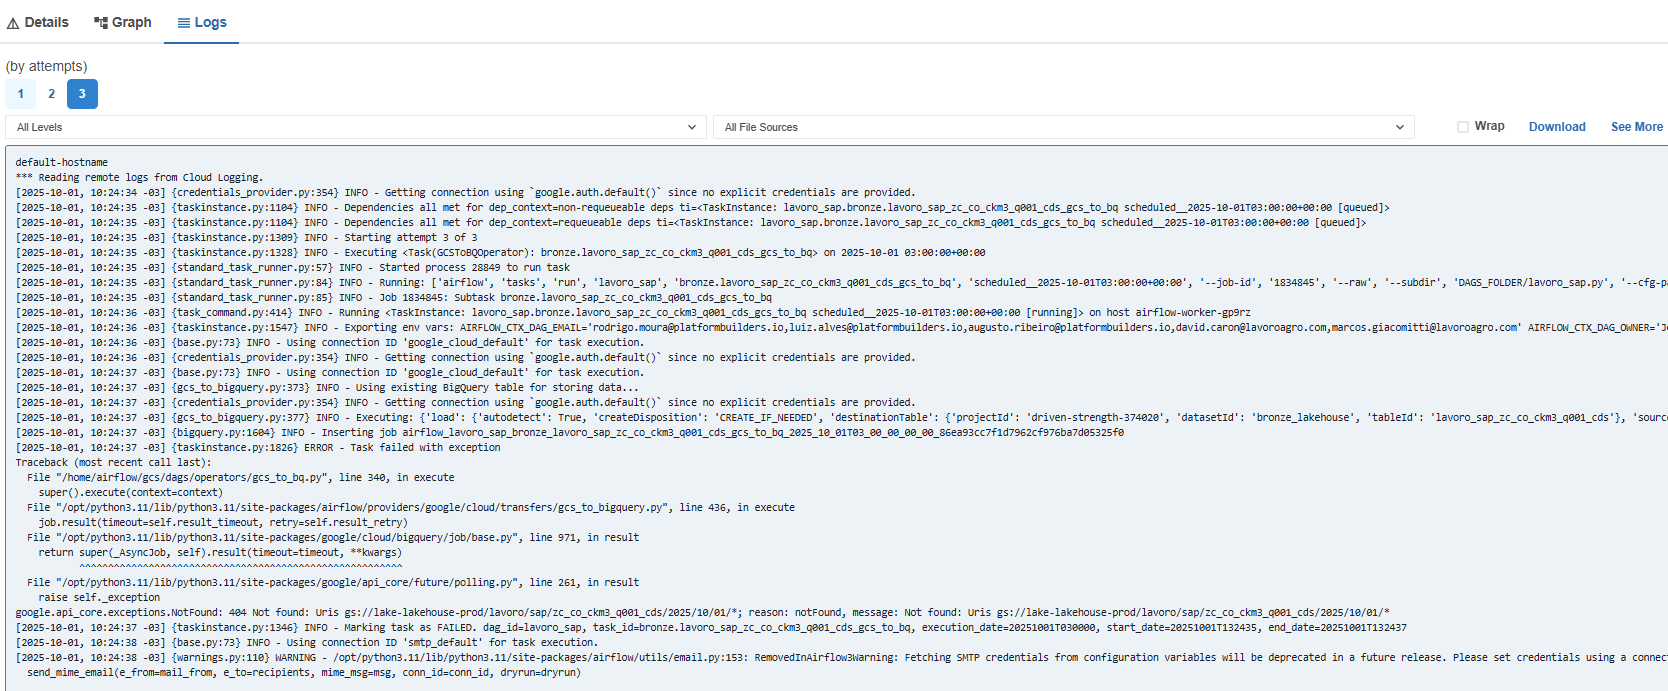 Logs detalhados de execução de cada task individual, essencial para debugging e troubleshooting.
Alertas e Notificações
Configuramos diversos tipos de alertas para garantir a qualidade e disponibilidade dos dados:
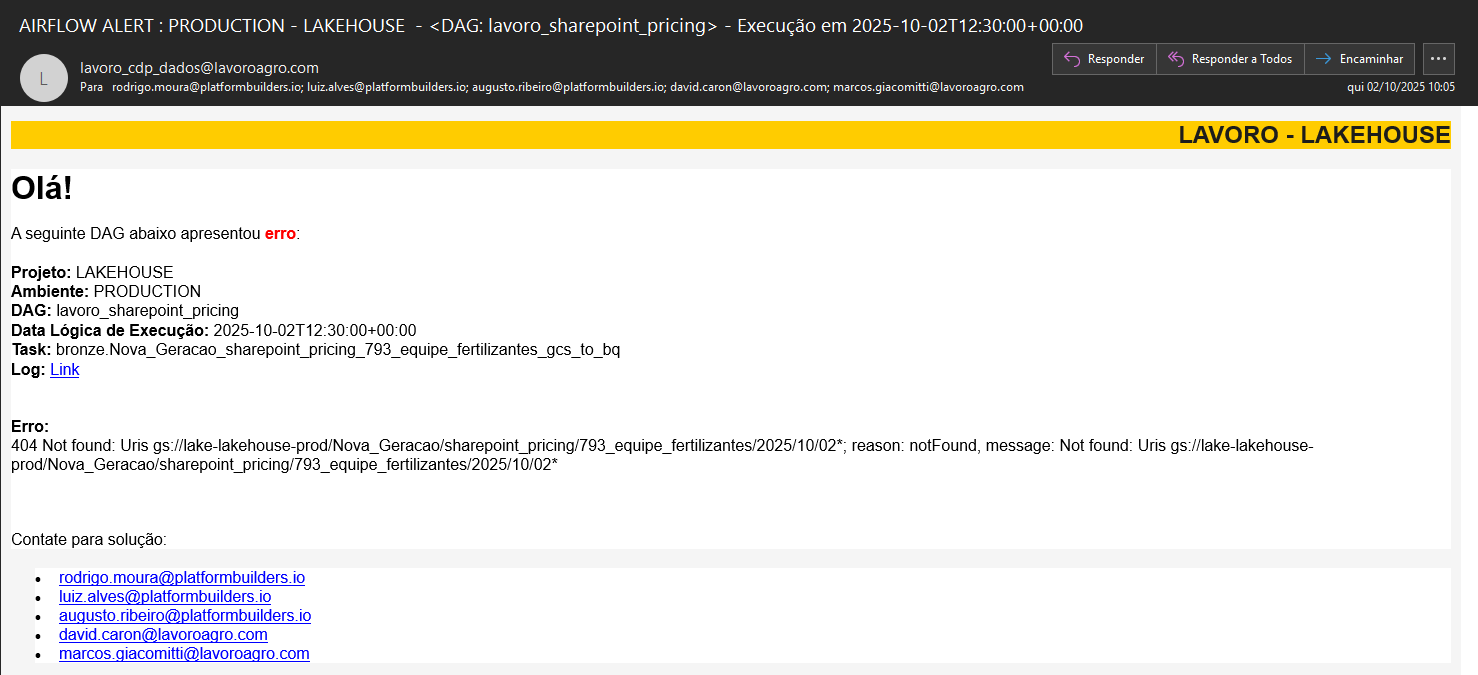
❌ Falha de DAG
Quando uma DAG falha, alertas são enviados automaticamente para a lista de e-mail do time de engenharia de dados.
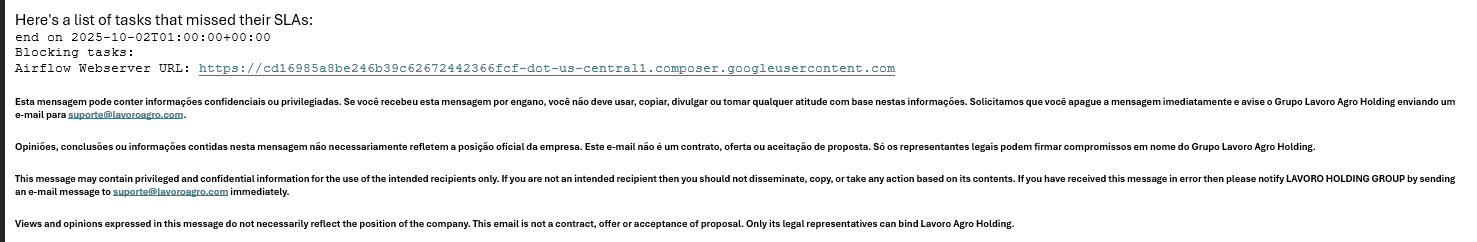
⏰ SLA Violado
Notificações quando os dados não chegam dentro do prazo esperado (SLA - Service Level Agreement), alertando o time de dados.
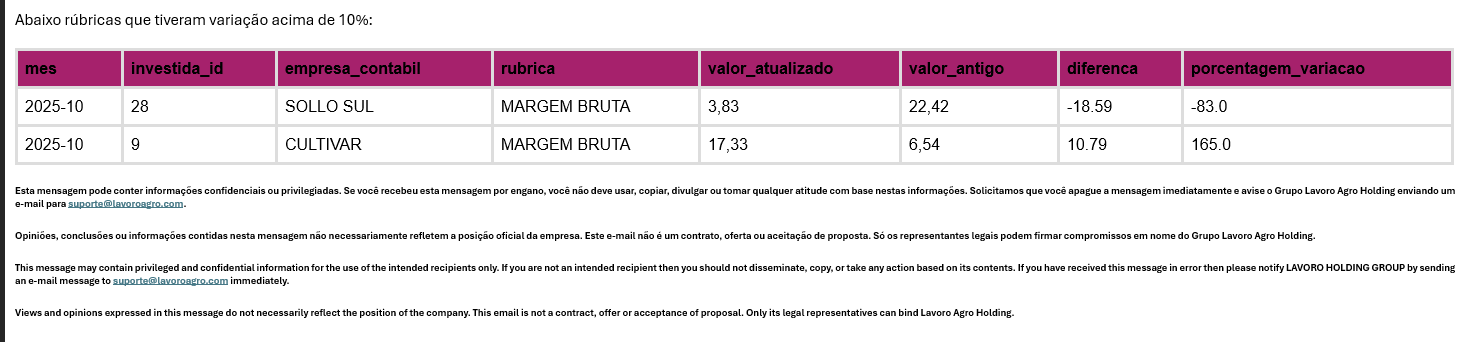
🎯 Motor de E-mail Customizado
Utilizamos um motor de e-mail customizado para enviar alertas específicos baseados em regras de negócio, como:
- Validações de qualidade de dados
- Alertas de volumes anormais
- Notificações de conclusão de pipelines críticos
- Alertas de recursos (CPU/Memória acima de 80%)
Métricas Principais
| Métrica | Descrição | Alerta |
|---|---|---|
| Task Duration | Tempo médio de execução | > 2x média |
| Scheduler Heartbeat | Latência do scheduler | > 30s |
| Worker Utilization | % de workers ocupados | > 90% |
🎯 Boas Práticas
1. Idempotência
DAGs devem ser idempotentes (executar múltiplas vezes produz o mesmo resultado):
# ✅ BOM - Idempotente
sql = """
    MERGE INTO silver_cdp.clientes AS target
    USING (SELECT * FROM bronze_cdp.clientes WHERE date = '{{ ds }}') AS source
    ON target.id = source.id
    WHEN MATCHED THEN UPDATE SET ...
    WHEN NOT MATCHED THEN INSERT ...
"""

# ❌ RUIM - Não idempotente
sql = "INSERT INTO silver_cdp.clientes SELECT * FROM bronze_cdp.clientes"
2. Uso de Templates
Use Jinja templates para valores dinâmicos:
sql = """
    SELECT * FROM bronze_cdp.vendas
    WHERE data_venda = '{{ ds }}'  -- Data da execução
    AND data_venda >= '{{ macros.ds_add(ds, -7) }}'  -- Últimos 7 dias
"""
3. Testes de DAGs
Sempre incluir testes:
# dags/tests/test_cdp_dag.py
def test_dag_loads():
    """Testa se o DAG carrega sem erros"""
    from dags.cdp import cdp_bronze_to_silver
    assert cdp_bronze_to_silver is not None

def test_dag_structure():
    """Testa estrutura de dependências"""
    dag = cdp_bronze_to_silver
    assert len(dag.tasks) > 0
    assert 'extract_from_bronze' in [t.task_id for t in dag.tasks]
4. Documentação
Sempre documentar DAGs:
dag = DAG(
    dag_id='cdp_bronze_to_silver',
    description='Pipeline CDP: Bronze → Silver com limpeza e validação',
    doc_md="""
    ## Pipeline CDP: Bronze → Silver

    Este DAG realiza:
    1. Extração de dados brutos da camada Bronze
    2. Limpeza e normalização de dados
    3. Aplicação de regras de negócio
    4. Carga na camada Silver

    **SLA:** Dados disponíveis até 06:00
    **Owner:** Time de Engenharia de Dados
    """,
    tags=['cdp', 'silver', 'daily']
)
📚 Recursos Adicionais
🔄 Orquestração de Pipelines - Apache Airflow
Última atualização: Janeiro 2025