Arquitetura Técnica - Data Lake Lavoro
Esta página documenta a arquitetura técnica completa do Data Lake Lavoro, incluindo stack tecnológica, infraestrutura como código (IaC) e CI/CD.
🏗️ Visão Geral da Arquitetura
Diagrama Completo

Componentes da Arquitetura
Fontes de Dados
- ERP: Conexão diretamente no Banco de Dados dos sistemas ERP's (Protheus, Elevor, HPRO, VIASOFT, Siagri, Agrotis)
- APIs: Integrações com sistemas externos via REST/SOAP (SAPB1 e SAP)
- Excel: Planilhas de dados contabeis/comerciais/operacionais
Ingestão e Tratamento
- Cloud Composer (Airflow): Orquestração de pipelines com DAGs programados
- Cloud Storage API: Upload de arquivos brutos para Cloud Storage
- BigQuery API: Ingestão direta de dados estruturados no BigQuery
Data Lake - BigQuery
- 🥉 Bronze (Tables): Dados brutos ingeridos via Parquet no Cloud Storage e armazenados como tabelas nativas BigQuery
- 🥈 Silver: Dados limpos, validados e normalizados
- 🥇 Gold: Dados agregados e otimizados para consumo
Governança de Dados
- Dataplex: Catalogação, descoberta, acesso e qualidade de dados
- Data Loss Prevention (DLP): Detecção e proteção de dados sensíveis (PII)
Machine Learning
- BigQuery ML: Modelos de ML treinados diretamente no BigQuery
- Vertex AI: Plataforma completa para MLOps
- Managed Notebooks: Jupyter notebooks gerenciados para análises
Consumo
- Power BI: Dashboards e relatórios interativos de negócio
- Sharepoint Input em listas de produtos e plano de contas
Monitoramento
- Cloud Monitoring: Métricas, dashboards e alertas operacionais
- Cloud Logging: Logs centralizados de pipelines e queries
IaC e CI/CD
- GitHub: Repositório de código (DAGs, SQL, Python)
- GitHub Actions: Automação de testes e deploy
- Terraform: Provisionamento de infraestrutura como código
Acesso e Segurança
- Secret Manager: Gerenciamento seguro de credenciais e chaves
- IAM: Controle de acesso granular (quem pode acessar o quê)
📊 Fontes de Dados
Sistemas Integrados
O Data Lake consolida dados de múltiplas fontes heterogêneas, organizadas por categoria:
ERP Operacional
Sistemas de gestão empresarial que fornecem dados de operações, estoque, vendas e contabilidade:
| Sistema | Empresas | Tecnologia |
|---|---|---|
| SAP S/4HANA | Lavoro | REST API |
| Protheus | Desempar, Futuragro | SQL Server (ODBC) |
| SAP B1 | Nova Geração | REST API (Service Layer) |
| HPRO | Qualicitrus | SQL Server (ODBC) |
| Elevor | Casa Trevo, Referência | SQL Server (ODBC) |
| Siagri | Floema | Oracle (ODBC) |
| Agrotis | Coram, Produttiva | SQL Server (ODBC) |
| Gerpa | Cultivar | SQL Server (ODBC) |
| Viasoft | Sollosul | Oracle (ODBC) |
ERP de Crédito Agrícola
Plataformas especializadas em análise de crédito e risco para o agronegócio:
| Sistema | Uso | Tecnologia |
|---|---|---|
| Agrometrika | Análise de crédito rural | REST API |
| Tarken | Trading e gestão de commodities | REST API |
| Traive | Seguro e crédito agrícola | REST API |
Sistemas Corporativos
Ferramentas de gestão interna da Lavoro:
| Sistema | Uso | Tecnologia |
|---|---|---|
| SharePoint | Planilhas e listas corporativas | Microsoft Graph API |
| Jira | Gestão de projetos de TI | REST API |
| TopDesk | Service Desk - Chamados de TI | REST API |
Dados Financeiros
Fontes de dados financeiros e macroeconômicos:
| Sistema | Uso | Tecnologia |
|---|---|---|
| BACEN | Cotações de moedas e taxas | REST API |
| Hedger | Derivativos e operações de hedge | REST API |
| Nexxera | Plataforma de tesouraria | SFTP |
Padrões de Integração
Todas as integrações seguem o mesmo fluxo arquitetural:
graph LR
    A[Sistema Fonte] -->|Extração| B[Cloud Storage - Parquet]
    B -->|Load| C[BigQuery Bronze]
    C -->|Transform| D[BigQuery Silver]
    D -->|Aggregate| E[BigQuery Gold]
    E -->|Consume| F[Power BI / APIs]

    style B fill:#e8f4f8
    style C fill:#cd7f32,color:#fff
    style D fill:#c0c0c0
    style E fill:#ffd700
Características:
- ✅ Staging em Parquet: Todos os dados passam por Cloud Storage em formato Parquet antes do BigQuery
- ✅ Rastreabilidade: Coluna
extraction_timestampautomática em todas as extrações - ✅ Idempotência: Cargas diárias podem ser reprocessadas sem duplicação
- ✅ Particionamento: Bronze particionado por data de ingestão para reprocessamento eficiente
⚠️ Caso especial: HPRO (Qualicitrus)
Por limitação do próprio HPRO, a extração desse sistema não segue o fluxo padrão (Airflow → Cloud Storage → BigQuery). Em vez disso, usamos um caminho assíncrono via Pub/Sub e uma VM legada.
Fluxo
graph LR
    A[⏰ Airflow] -->|Publica mensagem| B[📣 Pub/Sub]
    B -->|Consome mensagem| C[🖥️ vm_legado]
    C -->|Executa| D["🐍 windows/hpro_upload_to_gcs.py"]
    D -->|1. Roda query| E[(💾 HPRO DB)]
    E -->|2. Retorna dados| D
    D -->|3. Gera e sobe Parquet| F[☁️ GCS]
    F -->|Load| G[🥉 Bronze BigQuery]

    style B fill:#fce4ec
    style C fill:#fff3e0
    style F fill:#e3f2fd
    style G fill:#cd7f32,color:#fff
Passo a passo
- O Airflow dispara uma mensagem de extração no Pub/Sub.
- A vm_legado consome a mensagem do Pub/Sub.
- A VM dispara o script
windows/hpro_upload_to_gcs.py(caminho dentro da própria VM, originalmente versionado emlavoro-lakehouse-prod/windows/). - O script roda a query no banco HPRO e recebe os dados.
- Após receber o resultado, o script gera o arquivo Parquet e o envia para o GCS.
- A partir daí o fluxo segue o padrão: GCS → Bronze → Silver → Gold.
Disclaimer
Este caminho é design, não defeito. A VM legada e o trampolim via Pub/Sub são a única forma viável de extrair dados do HPRO hoje, dada a limitação do sistema fonte.
🛠️ Stack Tecnológica
Infraestrutura em Nuvem (GCP)
Computação e Processamento
| Serviço | Uso | Justificativa |
|---|---|---|
| Cloud Composer | Orquestração de pipelines (Airflow) | Gerenciamento de DAGs, agendamento, monitoramento |
| BigQuery | Data warehouse e transformações SQL | Performance, escalabilidade, custo por query |
| Python | Scripts de transformação | Flexibilidade para lógicas complexas |
Armazenamento
| Serviço | Uso | Formato |
|---|---|---|
| Cloud Storage | Staging de arquivos brutos | Parquet |
| BigQuery | Data warehouse (Bronze, Silver, Gold) | SQL |
Ingestão de Dados
| Método | Fontes | Tecnologia |
|---|---|---|
| APIs REST/SOAP | ERP, APIs externas | Ingestão via Parquet no Cloud Storage → BigQuery |
| Arquivos | Excel, CSV | Ingestão via Parquet no Cloud Storage → BigQuery |
| Bancos de Dados | SQL Server, Oracle, DBISAM | Ingestão via Parquet no Cloud Storage → BigQuery |
Monitoramento e Logs
| Serviço | Uso |
|---|---|
| Cloud Logging | Logs centralizados de pipelines e DAGs |
| Cloud Monitoring | Métricas, alertas e dashboards operacionais |
🏗️ Infraestrutura como Código (IaC)
Terraform
Utilizamos Terraform para provisionar e gerenciar toda a infraestrutura do Data Lake de forma declarativa e versionada.
Estrutura do Projeto Terraform
terraform/
├── main.tf
├── roles.tf
├── infra_roles.tf
├── default_firewall.tf
├── default_nat.tf
├── vm_openvpn.tf
└── modules/
    ├── bigquery-table/
    │   ├── main.tf
    │   ├── variables.tf
    │   └── outputs.tf
    ├── authorized-view/
    └── data-project/
Exemplo: Módulo de Tabela BigQuery
# modules/bigquery-table/main.tf
resource "google_bigquery_table" "_" {
  project             = var.project_id
  dataset_id          = var.dataset_id
  table_id            = var.table_id
  deletion_protection = var.deletion_protection
  description         = var.description

  # View (se aplicável)
  dynamic "view" {
    for_each = var.query == null ? [] : [var.query]
    content {
      query          = view.value
      use_legacy_sql = var.use_legacy_sql
    }
  }

  # Particionamento
  dynamic "time_partitioning" {
    for_each = var.time_partitioning_field == null ? [] : [var.time_partitioning_field]
    content {
      type  = var.time_partitioning_type
      field = var.time_partitioning_field
    }
  }
}
Exemplo: Uso do Módulo
# main.tf
module "bronze_cdp_clientes" {
  source = "./modules/bigquery-table"

  project_id          = "projeto-lavoro"
  dataset_id          = "bronze_cdp"
  table_id            = "clientes"
  description         = "Tabela bronze com dados brutos de clientes"
  deletion_protection = true

  time_partitioning_field = "data_ingestao"
  time_partitioning_type  = "DAY"
}

module "silver_cdp_dim_clientes" {
  source = "./modules/bigquery-table"

  project_id          = "projeto-lavoro"
  dataset_id          = "silver_cdp"
  table_id            = "dim_clientes"
  description         = "Dimensão de clientes limpa e validada"
  deletion_protection = true
}
Comandos Terraform
# Inicializar Terraform
terraform init

# Planejar mudanças
terraform plan -out=tfplan

# Aplicar mudanças
terraform apply tfplan

# Validar recursos
terraform validate

# Formatar código
terraform fmt -recursive
Benefícios do IaC com Terraform
- ✅ Versionamento: Infraestrutura versionada no Git
- ✅ Reprodutibilidade: Ambientes idênticos (dev, staging, prod)
- ✅ Documentação: Código é a documentação
- ✅ Auditoria: Rastreamento de mudanças via commits
- ✅ Recuperação: Recriação rápida de infraestrutura
🔄 CI/CD Pipeline
Estratégia de CI/CD
Utilizamos GitHub Actions para automação de testes, validação e deploy dos pipelines do Airflow.
Workflow de Desenvolvimento
graph TD
    A[Desenvolvedor] -->|1. Commit e Push| B[GitHub]
    B -->|2. Dispara| C[GitHub Actions]
    C -->|3. Testes| D{Passou?}
    D -->|Não| E[Notifica Desenvolvedor]
    D -->|Sim| F[Deploy QA]
    F -->|4. Validação QA| G{OK?}
    G -->|Não| E
    G -->|Sim| H[Criar PR para Main]
    H -->|5. Code Review| I{Aprovado?}
    I -->|Não| E
    I -->|Sim| J[Merge Main]
    J -->|6. Deploy Produção| K[GCP - Prod]
GitHub Actions Workflows
1. Workflow de Testes (Pull Request)
Arquivo: .github/workflows/pr.yml
name: Tests

on:
  pull_request:
    branches:
      - qa
      - main

jobs:
  test:
    runs-on: ubuntu-latest
    env:
      AIRFLOW_VAR_ENV: production
    steps:
      - name: Checkout
        uses: actions/checkout@v2

      - name: Set up Python
        uses: actions/setup-python@v3
        with:
          python-version: '3.8'

      - name: Install Python dependencies
        run: |
          pip install --no-cache-dir -r docker/requirements.txt -c docker/constraints.txt
          pip check

      - name: Create Airflow DB
        run: |
          airflow db init

      - name: Lint with Flake8
        run: |
          flake8 --max-complexity 20 --max-line-length 150 \
            --select E101,E111,E501,E999,W191,W603,F402,F403,F812,F821,F823,C901 \
            dags || exit

      - name: Tests with Pytest
        id: test
        run: |
          pushd dags/tests || exit
          python3 -m pytest --disable-pytest-warnings --numprocesses=auto || exit
          popd || exit
O que faz:
- ✅ Executa em Pull Requests para
qaemain - ✅ Instala dependências do Airflow
- ✅ Inicializa banco de dados do Airflow
- ✅ Executa linting com Flake8
- ✅ Executa testes unitários com Pytest
- ✅ Bloqueia merge se algum teste falhar
2. Workflow de Deploy (Push para QA)
Arquivo: .github/workflows/push_qa.yml
name: Deploy to GCP (QA)

on:
  push:
    branches:
      - qa

jobs:
  deploy:
    runs-on: ubuntu-latest
    environment: qa
    env:
      AIRFLOW_VAR_ENV: qa
    steps:
    - name: Checkout repo
      uses: actions/checkout@v2

    - name: Set up Google Cloud SDK
      uses: google-github-actions/setup-gcloud@v0.2.0
      with:
        project_id: ${{ secrets.GCP_PROJECT_ID }}
        service_account_key: ${{ secrets.SECRET_AIRFLOW }}
        export_default_credentials: true

    - name: Start Airflow VM
      run: |
        gcloud compute instances start vm-airflow-lavoro-operacoes-qa --zone us-central1-a

    - name: Clean up dags directory in Airflow VM
      run: |
        gcloud compute ssh vm-airflow-lavoro-operacoes-qa --zone us-central1-a \
          --command "sudo rm -rf /home/airflow/lavoro-operacoes/dags/*"

    - name: Clean up docker directory in Airflow VM
      run: |
        gcloud compute ssh vm-airflow-lavoro-operacoes-qa --zone us-central1-a \
          --command "sudo rm -rf /home/airflow/lavoro-operacoes/docker/*"

    - name: Copy dags to Airflow VM
      run: |
        gcloud compute scp --recurse ./dags vm-airflow-lavoro-operacoes-qa:/tmp/ \
          --zone us-central1-a

    - name: Copy docker to Airflow VM
      run: |
        gcloud compute scp --recurse ./docker vm-airflow-lavoro-operacoes-qa:/tmp/ \
          --zone us-central1-a

    - name: Move dags to final directory
      run: |
        gcloud compute ssh vm-airflow-lavoro-operacoes-qa --zone us-central1-a \
          --command "sudo mv /tmp/dags/* /home/airflow/lavoro-operacoes/dags/"

    - name: Move docker to final directory
      run: |
        gcloud compute ssh vm-airflow-lavoro-operacoes-qa --zone us-central1-a \
          --command "sudo mv /tmp/docker/* /home/airflow/lavoro-operacoes/docker/"
O que faz:
- ✅ Executa automaticamente em push para branch
qa - ✅ Inicia a VM do Airflow no GCP
- ✅ Limpa diretórios antigos de DAGs e Docker
- ✅ Copia novos DAGs e arquivos Docker para a VM
- ✅ Move arquivos para diretórios finais
- ✅ Airflow recarrega DAGs automaticamente
3. Exemplo de Testes (Pytest)
Arquivo: dags/tests/tests.py
import pytest
import os
from airflow.models import DagBag


@pytest.mark.parametrize("dag_item", dag_list())
def test_external_dag_schedule(dag_item):
    dag_id, dag = dag_item
    error_msg = f"Scheduling of DAG {dag_id} does not match the scheduling of external DAGs"

    tasks = dag.tasks

    errors_list = []
    for task in tasks:
        class_name = type(task).__name__
        if class_name not in ["ExternalTaskSensor"]: continue

        external_dag_id = task.external_dag_id
        external_dag = get_dag(dag_list(), external_dag_id)
        if not external_dag_id: continue

        if dag.schedule_interval != external_dag.schedule_interval:
            errors_list.append(external_dag_id)

    assert len(errors_list) == 0, error_msg
Ambientes
| Ambiente | Branch | Deploy | Infraestrutura | Datasets |
|---|---|---|---|---|
| Dev | Feito na VM |
Manual | vm-airflow-lavoro-projeto-dev |
Sufixo _dev |
| QA | qa |
Automático (push) | vm-airflow-lavoro-projeto-qa |
Sufixo _qa |
| Produção | main |
Automático (push) | Cloud Composer (1 ambiente) | Sem sufixo |
Topologia Atual de Composer (Produção)
Histórico de consolidação
Anteriormente havia 3 Cloud Composers orquestrando 5 projetos. A topologia foi consolidada em 1 único Composer (Lakehouse) orquestrando os 4 projetos restantes (Lakehouse, CDP, Operações, Pessoas). O projeto Tesouraria foi descontinuado.
| Composer | Projetos Orquestrados | Repositório |
|---|---|---|
| Composer Lakehouse | Lakehouse, CDP, Operações, Pessoas | lavoro-lakehouse |
Detalhamento dos Ambientes
🛠️ Dev (Desenvolvimento)
- Finalidade: Testes locais e desenvolvimento de novas features
- Infraestrutura: VM com Docker Compose (n2-standard-2)
- Datasets:
bronze_cdp_dev,silver_cdp_dev,gold_cdp_dev - Deploy: Manual - desenvolvedor trabalha diretamente na VM
- Dados: Pode usar dados de produção ou sintéticos
- Recursos: 2 vCPUs, 8 GB RAM
🧪 QA (Quality Assurance)
- Finalidade: Homologação e validação antes de produção
- Infraestrutura: VM com Docker Compose (n2-standard-2)
- Datasets:
bronze_cdp_qa,silver_cdp_qa,gold_cdp_qa - Deploy: Automático via GitHub Actions (push para branch
qa) - Dados: Cópia de produção ou dados de teste
- Recursos: 2 vCPUs, 8 GB RAM
- Validação: Testes automatizados + validação manual
🚀 Prod (Produção)
- Finalidade: Ambiente de produção com dados reais
- Infraestrutura: 1 Cloud Composer gerenciado (Lakehouse, autoscaling)
- Versões: Composer 2.16.1 | Airflow 2.10.3
- Datasets:
bronze_cdp,silver_cdp,gold_cdp(sem sufixo) - Deploy: Automático via GitHub Actions (push para branch
main) - Dados: Dados oficiais da empresa
- Recursos: Gerenciado pelo GCP (escala conforme demanda)
- SLA: Alta disponibilidade garantida
Alternância entre Ambientes no Código
A configuração de ambiente é controlada pelo arquivo project_params.py:
# dags/config/project_params.py
import os

# Define ambiente via variável Airflow
ENV = os.getenv('AIRFLOW_VAR_ENV', 'production')

if ENV == 'development':
    BQ_BRONZE = 'bronze_cdp_dev'
    BQ_SILVER = 'silver_cdp_dev'
    BQ_GOLD = 'gold_cdp_dev'
elif ENV == 'qa':
    BQ_BRONZE = 'bronze_cdp_qa'
    BQ_SILVER = 'silver_cdp_qa'
    BQ_GOLD = 'gold_cdp_qa'
else:  # production
    BQ_BRONZE = 'bronze_cdp'
    BQ_SILVER = 'silver_cdp'
    BQ_GOLD = 'gold_cdp'
✅ Qualidade de Código: Validadores e Testes
Validadores Automáticos de Pull Requests
Antes de qualquer código ser mergeado, executamos validadores automáticos via GitHub Actions que garantem conformidade com padrões de qualidade e governança.
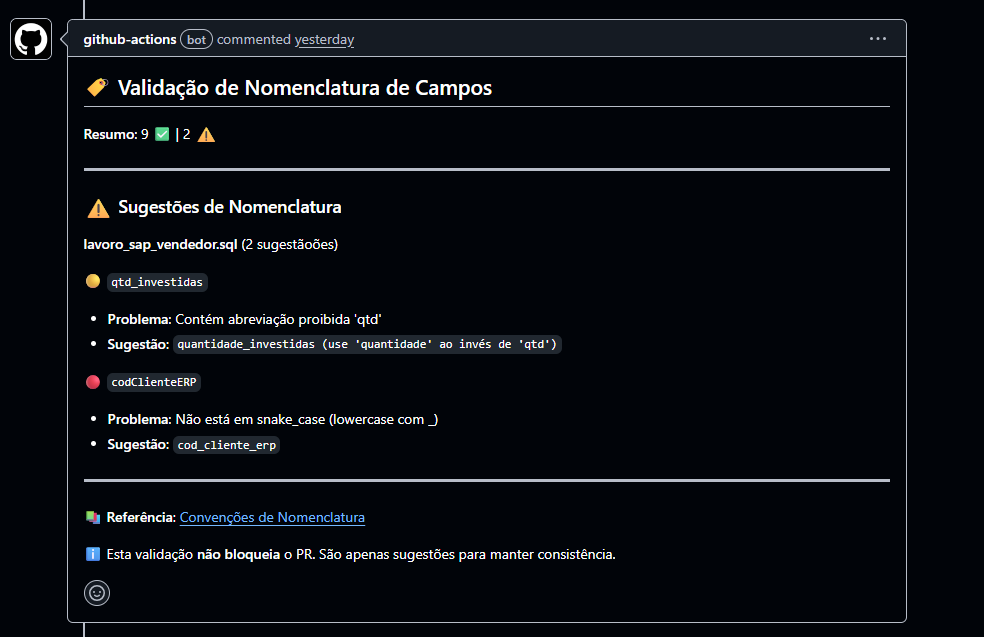
1. Validador de Nomenclatura (validate_naming.py)
O que valida:
- Se seguimos as conveções definidas dentro do projeto.
- Nomenclatura de colunas (lowercase, snake_case)
- Sufixos padronizados (_id, _date, _flg, etc.)
Comportamento: ⚠️ Apenas emite avisos e não bloqueia o merge do PR
Exemplo de aviso:
Como corrigir:
- Renomear tabela/coluna seguindo convenções documentadas em convencoes.md
- Verificar se está usando lowercase e snake_case
- Conferir prefixos obrigatórios (
dim_,fato_para Gold)
2. Validador de Documentação (validate_documentation.py)
O que valida:
- 100% de cobertura obrigatória - todas as tabelas Silver e Gold devem ter
table_description - 100% de cobertura obrigatória - todas as colunas devem ter
descriptionno schema - Documentação está no formato correto (dicionário Python)
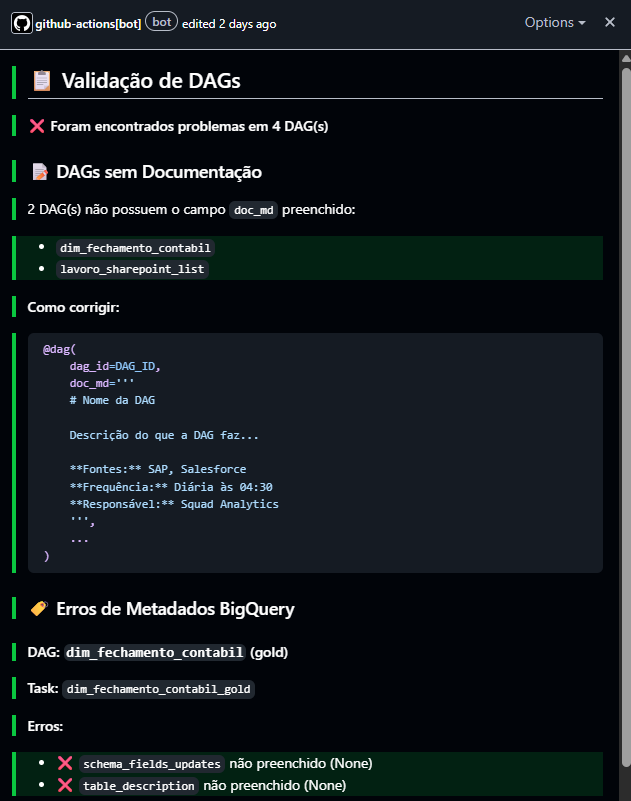
Comportamento: ❌ Bloqueia o merge se documentação estiver incompleta
Exemplo de erro:
Como corrigir:
- Adicionar documentação completa no operator
BQInsertJobOperator:table_metadata = { 'table_description': 'Cadastro de clientes da Lavoro SAP...', 'schema_fields_updates': [ {'name': 'cliente_id', 'description': 'Identificador único do cliente no SAP'}, {'name': 'nome', 'description': 'Razão social do cliente'}, {'name': 'data_cadastro', 'description': 'Data de criação do cadastro no sistema'} # TODAS as colunas devem ter description ] }
3. Validador de Complexidade SQL (validate_sql_complexity.py)
Analisa queries SQL e calcula um score de complexidade baseado em 9 métricas diferentes, cada uma com peso específico.
Comportamento:
- ✅ Score 0-60: Aprovado automaticamente
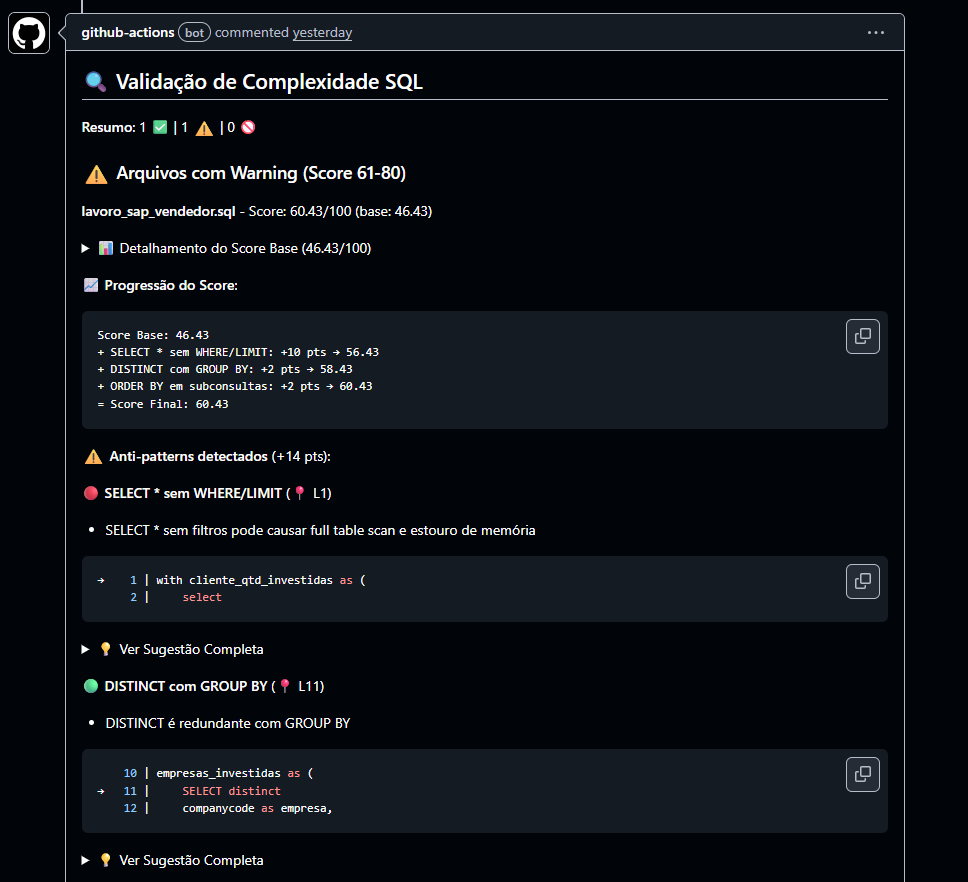
- ⚠️ Score 61-80: Gera aviso, mas permite merge
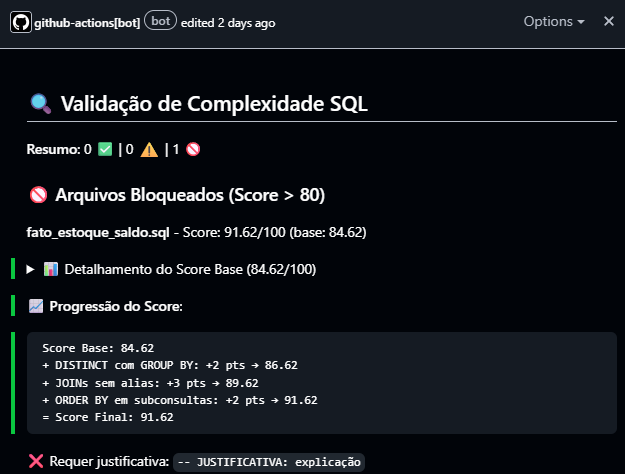
- ❌ Score 81-100: Bloqueia o merge do PR, caso não haja justificativa
📐 Fórmula de Cálculo
O score é calculado em duas etapas:
1. Score Base (normalizado de 0 a 100):
2. Score Final (com penalidades):
📊 Métricas e Pesos
| Métrica | Peso | Valor Máximo | O que detecta |
|---|---|---|---|
| CTEs | 4 | 6 | Número de Common Table Expressions (WITH) |
| Joins | 6 | 10 | Quantidade de JOINs (INNER, LEFT, RIGHT, FULL) |
| Subqueries | 10 | 5 | Subqueries em SELECT, WHERE, FROM |
| Nested Depth | 10 | 4 | Profundidade máxima de aninhamento |
| CASE Statements | 2 | 8 | Quantidade de CASE WHEN |
| Window Functions | 5 | 5 | Funções analíticas (ROW_NUMBER, RANK, etc.) |
| Aggregations | 1 | 15 | COUNT, SUM, AVG, MIN, MAX |
| UNIONs | 4 | 3 | UNION e UNION ALL |
| Lines | 10 | 400 | Linhas de código SQL |
⚠️ Anti-padrões (Penalidades Adicionais)
Cada anti-padrão detectado adiciona pontos ao score final:
| Anti-padrão | Penalidade | Como detecta |
|---|---|---|
SELECT * |
+10 | Regex: SELECT\s+\* |
| Subquery em SELECT | +5 | AST: subquery dentro de SELECT list |
| Self-join sem alias claro | +3 | JOIN da mesma tabela sem ALIAS |
| DISTINCT desnecessário | +2 | DISTINCT em query com GROUP BY |
| OR em WHERE complexo | +2 | Múltiplos OR sem parênteses |
📋 Exemplos de Erros
Score 85 - BLOQUEADO:
Score 72 - AVISO:
🔧 Como Corrigir
1. Dividir em CTEs menores:
-- ❌ Subquery aninhada (Score alto)
SELECT cliente_id,
       (SELECT COUNT(*) FROM pedidos WHERE pedidos.cliente_id = clientes.id) as total_pedidos
FROM clientes

-- ✅ CTE separada (Score menor)
WITH contagem_pedidos AS (
    SELECT cliente_id, COUNT(*) as total_pedidos
    FROM pedidos
    GROUP BY cliente_id
)
SELECT c.cliente_id, cp.total_pedidos
FROM clientes c
LEFT JOIN contagem_pedidos cp ON c.id = cp.cliente_id
2. Criar tabelas Silver intermediárias:
-- Em vez de uma query Gold de 400 linhas com 10 JOINs,
-- criar múltiplas Silver intermediárias:
-- silver_cdp.vendas_enriquecidas (primeiros 5 JOINs)
-- silver_cdp.produtos_completos (próximos 5 JOINs)
-- gold_cdp.fato_vendas (JOIN simples das Silver)
3. Remover anti-padrões:
-- ❌ SELECT *
SELECT * FROM clientes

-- ✅ Colunas explícitas
SELECT cliente_id, nome, cpf, cidade FROM clientes
Workflow de Validação
graph TD
    A[Developer cria PR] --> B[GitHub Actions dispara]
    B --> C{validate_naming.py}
    C -->|⚠️ Warning| D{validate_documentation.py}
    D -->|✅ Pass| F{validate_sql_complexity.py}
    D -->|❌ Fail| E[❌ Bloqueia PR]
    F -->|✅ Pass / ⚠️ Warning| G[Executa Testes Pytest]
    F -->|❌ Fail Score > 80| E
    G -->|✅ Pass| H[✅ PR aprovado para merge]
    G -->|❌ Fail| E

    style E fill:#ff6b6b,color:#fff
    style H fill:#51cf66,color:#fff
    style C fill:#ffd43b,color:#000
    style F fill:#ffd43b,color:#000
Testes Automatizados (Pytest)
Além dos validadores, executamos testes unitários e de integração para garantir que os DAGs funcionam corretamente.
Tipos de Testes
1. Teste de Carregamento de DAG
Valida se o DAG carrega sem erros de sintaxe:
# dags/tests/tests.py
def test_dag_loads():
    """Testa se todos os DAGs carregam sem erros"""
    from airflow.models import DagBag

    dagbag = DagBag(dag_folder='dags/', include_examples=False)
    assert len(dagbag.import_errors) == 0, f"Erros de importação: {dagbag.import_errors}"
2. Teste de Estrutura de DAG
Valida a estrutura e dependências entre tasks:
def test_dag_structure():
    """Testa se as tasks estão corretamente conectadas"""
    dag = get_dag('cdp_bronze_to_silver')

    # Verifica que existem tasks
    assert len(dag.tasks) > 0

    # Verifica dependências esperadas
    bronze_task = dag.get_task('extract_bronze')
    silver_task = dag.get_task('transform_silver')

    assert silver_task in bronze_task.downstream_list
3. Teste de Schedule Interval
Valida que schedules de DAGs dependentes são compatíveis:
@pytest.mark.parametrize("dag_item", dag_list())
def test_external_dag_schedule(dag_item):
    """Valida que ExternalTaskSensor tem schedule compatível"""
    dag_id, dag = dag_item

    for task in dag.tasks:
        if type(task).__name__ == "ExternalTaskSensor":
            external_dag_id = task.external_dag_id
            external_dag = get_dag(dag_list(), external_dag_id)

            # Schedule deve ser igual
            assert dag.schedule_interval == external_dag.schedule_interval
4. Teste de Argumentos Padrão
Valida configurações de retry e alertas:
def test_default_args():
    """Valida que default_args estão corretos"""
    dag = get_dag('cdp_bronze_to_silver')

    assert dag.default_args['retries'] == 3
    assert dag.default_args['email_on_failure'] is True
    assert dag.default_args['owner'] == 'data-engineering'
Como Executar Testes Localmente
1. Instalar dependências:
2. Inicializar banco Airflow:
3. Executar testes:
4. Executar testes com cobertura:
Como Adicionar Novos Testes
1. Criar arquivo de teste:
# dags/tests/test_meu_dag.py
import pytest
from airflow.models import DagBag

def test_meu_novo_dag():
    """Testa meu novo DAG"""
    dagbag = DagBag()
    dag = dagbag.get_dag('meu_novo_dag')

    assert dag is not None
    assert len(dag.tasks) == 5
2. Executar:
🔐 Segurança e Governança
Controle de Acesso (IAM)
Estrutura de Permissões
Data Engineer User Role:
- Executar jobs de SQL em todas as camadas de tratamento
- Acesso e gestão do Composer
- Acesso e gestão das VMs de DEV e QA
- Acesso ao Storage
- Gerenciamento de Secrets
- Acesso ao Dataplex
Data Analyst User Role:
- Visualização e execução de jobs nas camadas Silver e Gold
- Acesso ao Composer
Dimensões Comuns
Para as aplicações e alguns jobs utilizamos contas de serviço de forma tirar a pessoalidade do acesso.
Governança com Dataplex
Estrutura do Lake
Mantemos 1 único Dataplex Lake que cobre todo o Data Lake Lavoro. Dentro desse lake, organizamos os datasets em zonas que correspondem às camadas medalhão (Bronze, Silver, Gold). A separação por ambiente (DEV, QA, PRD) é feita via sufixo de dataset (_dev, _qa, sem sufixo = PRD), e não via lakes ou zonas separadas.
graph TB
    LAKE["🏞️ Dataplex Lake (único)"]
    LAKE --> ZB["🥉 Zona Bronze"]
    LAKE --> ZS["🥈 Zona Silver"]
    LAKE --> ZG["🥇 Zona Gold"]

    ZB --> B1["bronze_lakehouse / _qa / _dev"]
    ZB --> B2["bronze_cdp / _qa / _dev"]
    ZB --> B3["bronze_operacoes / _qa / _dev"]
    ZB --> B4["bronze_pessoas / _qa / _dev"]

    ZS --> S1["silver_lakehouse / _qa / _dev"]
    ZS --> S2["silver_cdp / _qa / _dev"]
    ZS --> S3["silver_operacoes / _qa / _dev"]
    ZS --> S4["silver_pessoas / _qa / _dev"]

    ZG --> G1["gold_lakehouse / _qa / _dev"]
    ZG --> G2["gold_cdp / _qa / _dev"]
    ZG --> G3["gold_operacoes / _qa / _dev"]
    ZG --> G4["gold_pessoas / _qa / _dev"]

    style LAKE fill:#4285f4,color:#fff,stroke-width:2px
    style ZB fill:#cd7f32,color:#fff
    style ZS fill:#c0c0c0
    style ZG fill:#ffd700
Mapeamento Zona → Datasets
| Zona | Camada | Datasets PRD | Variantes por ambiente |
|---|---|---|---|
| Bronze | 🥉 Zona de entrada | bronze_lakehouse, bronze_cdp, bronze_operacoes, bronze_pessoas |
+ _dev, + _qa |
| Silver | 🥈 Zona validada | silver_lakehouse, silver_cdp, silver_operacoes, silver_pessoas |
+ _dev, + _qa |
| Gold | 🥇 Zona de consumo | gold_lakehouse, gold_cdp, gold_operacoes, gold_pessoas |
+ _dev, + _qa |
Funções
Dataplex é usado para:
- Catalogação automática de datasets
- Classificação de dados sensíveis
- Controle de acesso por zona e por dataset
- Linhagem de dados (integrado à Data Lineage API)
- Verificações de qualidade de dados (em conjunto com Soda Core)
Data Loss Prevention (DLP)
DLP protege dados sensíveis: - Detecção automática de PII (CPF, emails, telefones) - Mascaramento de dados em ambientes não-produtivos - Alertas de exposição de dados sensíveis
Boas Práticas de Segurança
- ✅ Service accounts por pipeline (princípio do menor privilégio)
- ✅ Secrets no Secret Manager (nunca no código)
- ✅ Cloud Audit Logs habilitados
- ✅ Criptografia em trânsito e em repouso
- ✅ Revisão periódica de acessos
📊 Projetos e Datasets
Estrutura de Datasets
Cada projeto possui 3 datasets principais seguindo a arquitetura Medalhão:
| Projeto | Datasets | Composer | Descrição |
|---|---|---|---|
| Lakehouse | bronze_lakehouse, silver_lakehouse, gold_lakehouse |
Composer Lakehouse | Vendas, Pedidos de Venda |
| CDP | bronze_cdp, silver_cdp, gold_cdp |
Composer Lakehouse | Customer Data Platform |
| Operações | bronze_operacoes, silver_operacoes, gold_operacoes |
Composer Lakehouse | Estoque, Compras, Custos, Contabilidade |
| Pessoas | bronze_pessoas, silver_pessoas, gold_pessoas |
Composer Lakehouse | Colaboradores e RH |
Frequência de Atualização de Dados
Todos os projetos seguem um padrão de atualização diária:
| Projeto | Frequência | Horário | Dados Disponíveis |
|---|---|---|---|
| CDP | Diária | Até 06:00 | D-1 (dia anterior) |
| Operações | Diária | Até 06:00 | D-1 (dia anterior) |
| Pessoas | Diária | Até 06:00 | D-1 (dia anterior) |
| Lakehouse | 3x ao dia | 06:00, 11:30, 16:30 | D-1 e intraday |
Atualização Lakehouse
O projeto Lakehouse possui atualização diferenciada com 3 execuções diárias para garantir dados mais recentes de vendas:
- 06:00: Atualização incremental (Dados D-1)
- 11:30: Atualização incremental (manhã)
- 16:30: Atualização incremental (tarde)
🔍 Monitoramento
Cloud Monitoring / Composer Monitoring
Métricas monitoradas:
- Tempo de execução de DAGs
- Taxa de sucesso/falha de pipelines
- Uso de recursos (CPU, memória, storage)
- Custos de BigQuery (queries, armazenamento)
Cloud Logging
Logs coletados:
- Execução de DAGs do Airflow
- Queries do BigQuery
- Erros e exceções
- Acessos a dados sensíveis
Alertas
Alertas configurados:
- Falhas de execução em Tasks/DAGS
- Custo do ambiente > threshold
- DAG's que passaram do SLA estimado (1h de execução)
🎯 Gerenciamento de Código
Estrutura de Repositórios GitHub
O código é organizado em 2 repositórios ativos sob a organização github.com/LavoroAgro:
lavoro-iac— Infraestrutura como código (Terraform).lavoro-lakehouse— Repositório único consolidado com DAGs, operators, hooks e templates SQL de todos os projetos (Lakehouse, CDP, Operações, Pessoas).
Repositórios históricos
Os repositórios lavoro-cdp, lavoro-operacoes, lavoro-tesouraria e lavoro-pessoas existem apenas como histórico. Todo o código foi consolidado em lavoro-lakehouse e novos commits devem ir somente para o repositório consolidado.
1. Repositório de Infraestrutura (IaC)
lavoro-iac/
├── terraform/
│   ├── main.tf
│   ├── roles.tf
│   ├── infra_roles.tf
│   ├── default_firewall.tf
│   ├── default_nat.tf
│   ├── vm_openvpn.tf
│   └── modules/
│       ├── bigquery-table/
│       ├── authorized-view/
│       └── data-project/
└── README.md
2. Repositório do Datalake (lavoro-lakehouse)
Repositório único com o código de DAGs, operators, hooks e templates SQL dos 4 projetos.
Estrutura padrão de cada repositório:
lavoro-{projeto}/
├── dags/                                    # Pasta raiz dos DAGs
│   ├── config/                              # Configurações e parâmetros
│   │   └── project_params.py                # Configurações de ambiente (DEV/QA/PROD)
│   │
│   ├── hooks/                               # Conexões com sistemas externos
│   │   ├── bq_hook.py                       # BigQuery connection handler
│   │   ├── sharepoint.py                    # SharePoint authentication
│   │   ├── sap_s4.py                        # SAP S/4HANA authentication
│   │   ├── ftp.py                           # FTP connection
│   │   ├── agrometrika.py                   # Agrometrika API auth
│   │   ├── tarken.py                        # Tarken platform auth
│   │   ├── cloud_function.py                # Cloud Functions auth
│   │   └── delta_sharing.py                 # Delta Sharing auth
│   │
│   ├── operators/                           # Operators customizados de extração
│   │   ├── lake_base.py                     # Base class para operators
│   │   ├── ftp_to_gcs.py                    # FTP → Cloud Storage
│   │   ├── gcs_to_bq.py                     # Cloud Storage → BigQuery
│   │   ├── excel_file_to_gcs.py             # Excel → Cloud Storage
│   │   ├── excel_file_to_bq.py              # Excel → BigQuery
│   │   ├── sharepoint_to_gcs.py             # SharePoint → Cloud Storage
│   │   ├── sharepoint_list.py               # SharePoint Lists integration
│   │   ├── sap_s4_to_gcs.py                 # SAP S/4HANA → Cloud Storage
│   │   ├── delta_sharing_to_gcs.py          # Databricks Delta Sharing → GCS
│   │   ├── bq_insert_job.py                 # BigQuery job insertion
│   │   ├── bq_get_data.py                   # BigQuery data retrieval
│   │   ├── bq_dry_run.py                    # BigQuery query validation
│   │   ├── cloud_function_invoke.py         # Google Cloud Functions invocation
│   │   ├── email.py                         # Email notifications
│   │   ├── agrometrika.py                   # Agrometrika-specific operator
│   │   └── tarken.py                        # Tarken-specific operator
│   │
│   ├── task_groups/                         # Grupos de tarefas organizadas por camada
│   │   ├── bronze/                          # Camada Bronze (dados brutos)
│   │   │   ├── {empresa}_{sistema}_bronze.py
│   │   │   └── ...
│   │   │
│   │   ├── silver/                          # Camada Silver (dados limpos)
│   │   │   ├── {empresa}_{sistema}_silver.py
│   │   │   └── sql/                         # Templates SQL para Silver
│   │   │       ├── {empresa}_{sistema}_{tabela}.sql
│   │   │       ├── protheus_cliente.sql     # Template reutilizável Jinja
│   │   │       ├── siagri_cliente.sql
│   │   │       └── ...
│   │   │
│   │   └── gold/                            # Camada Gold (dados agregados)
│   │       ├── dim_{entidade}_gold.py       # Task groups de dimensões
│   │       ├── fato_{metrica}_gold.py       # Task groups de fatos
│   │       └── sql/                         # Templates SQL para Gold
│   │           ├── dim_clientes.sql
│   │           ├── dim_produtos.sql
│   │           ├── fato_faturamento.sql
│   │           ├── fato_estoque.sql
│   │           └── ...
│   │
│   ├── utils/                               # Funções auxiliares
│   │   ├── dag.py                           # Helper functions para DAGs
│   │   └── sharepoint_utils.py              # Utilitários SharePoint
│   │
│   ├── tests/                               # Testes automatizados
│   │   └── tests.py                         # Suite de testes com Pytest
│   │
│   ├── {empresa}_{sistema}.py               # DAGs Bronze + Silver
│   ├── dim_{entidade}.py                    # DAGs de dimensões Gold
│   ├── fato_{metrica}.py                    # DAGs de fatos Gold
│   └── validacao_cargas.py                  # DAG de monitoramento de freshness
│
├── docker/                                  # Configuração Docker (DEV/QA)
│   ├── Dockerfile                           # Imagem customizada Airflow
│   ├── docker-compose.yml                   # Orquestração de containers
│   ├── requirements.txt                     # Dependências Python
│   └── constraints.txt                      # Versões fixas de dependências
│
├── .github/                                 # CI/CD
│   └── workflows/
│       ├── pr.yml                           # Workflow de testes em PRs
│       ├── push_qa.yml                      # Deploy automático para QA
│       └── push_main.yml                    # Deploy automático para PROD
│
├── README.md                                # Documentação do projeto
└── .gitignore                               # Arquivos ignorados pelo Git
Descrição dos Componentes
config/
- Armazena configurações de ambiente e parâmetros do projeto
- O arquivo
project_params.pycontém: - IDs de projetos BigQuery
- Nomes de datasets por ambiente (DEV/QA/PROD)
- Buckets do Cloud Storage
- Listas de emails para alertas
hooks/
- Abstrações para conectar com sistemas externos
- Cada hook gerencia:
- Autenticação (OAuth, API keys, service accounts)
- Conexão e retry logic
- Tratamento de erros específicos do sistema
operators/
- Operadores customizados que encapsulam lógicas de extração e carga
- Benefícios:
- Reutilização de código
- Padronização de extrações
- Logging e monitoramento consistente
- Facilita manutenção
task_groups/
- Organização modular das tarefas por camada do Data Lake:
- Bronze: Extrações de sistemas fonte
- Silver: Transformações e limpeza (SQL templates)
- Gold: Agregações e modelagem dimensional
utils/
- Funções auxiliares compartilhadas entre DAGs:
- Formatação de datas
- Manipulação de strings
- Helpers para Airflow (geração de task_id, etc.)
tests/
- Suite de testes automatizados:
- Testes de carregamento de DAG
- Validação de estrutura e dependências
- Testes de schedule intervals
- Validação de default_args
Sincronização
- GitHub: 1 repositório de projeto (
lavoro-lakehouse) + 1 repositório de IaC (lavoro-iac) - Cloud Composer: Deploy automático via CI/CD (GitHub Actions)
- Virtual Machine: Deploy automático via CI/CD (GitHub Actions)
- Sincronização: A cada push em
qaoumain, os DAGs são sincronizados automaticamente para o Composer